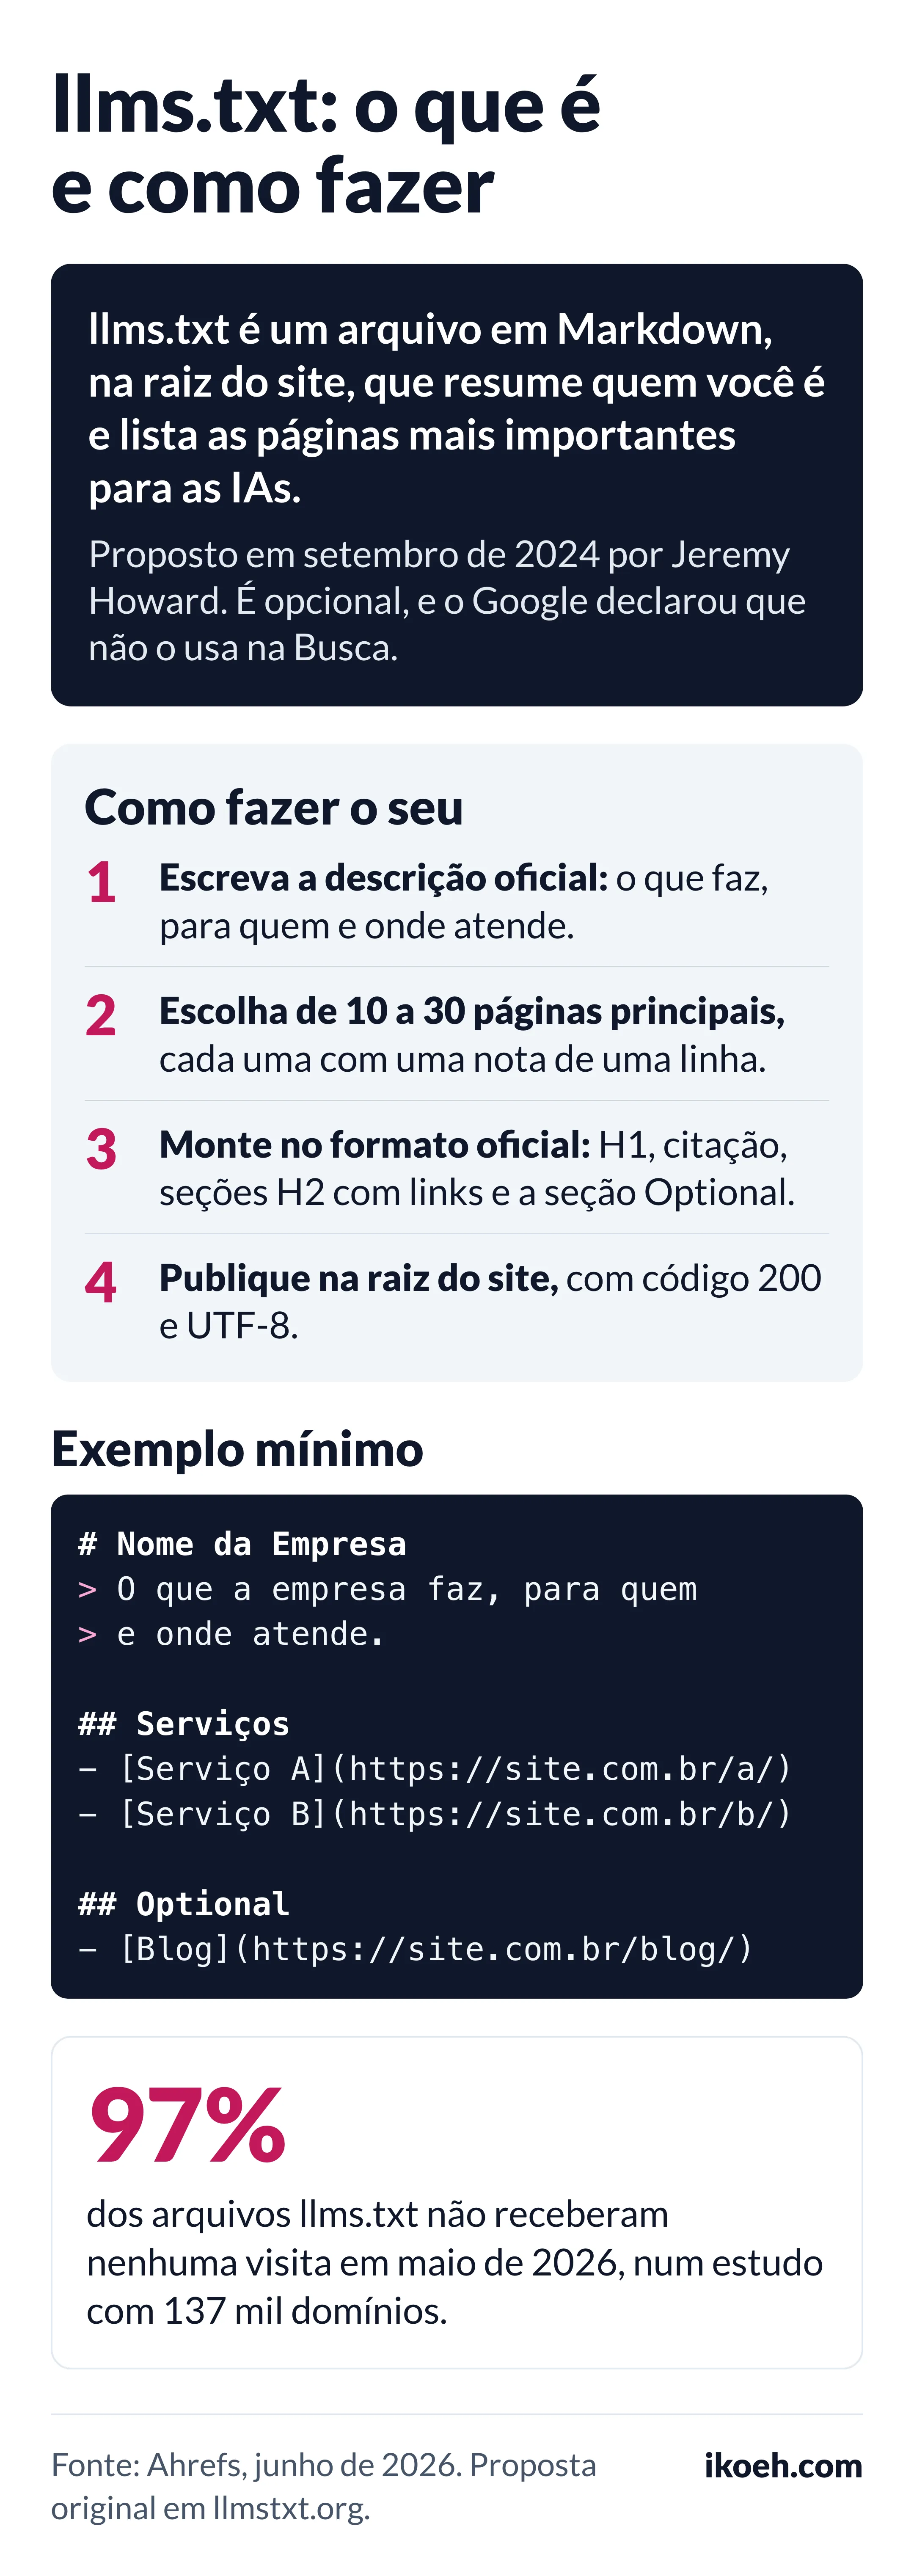
llms.txt é um arquivo de texto em formato Markdown, colocado na raiz do site (seusite.com.br/llms.txt), que resume quem você é e lista as páginas mais importantes com links e descrições curtas, para que modelos de linguagem e agentes de IA entendam o site sem precisar ler todo o HTML. Foi proposto em setembro de 2024 por Jeremy Howard e é opcional. O Google declarou que não o usa na Busca.
Pense em como um assistente de IA lê uma página comum. Antes de chegar ao que interessa, ele atravessa menu, rodapé, banner de cookies, script de anúncio, carrossel e pop-up de WhatsApp. Agora pense num cartão de visitas bem feito, entregue na mão: nome, o que faz, onde fica e os cinco endereços que valem a visita. O llms.txt quer ser esse cartão para as máquinas.
O que é llms.txt, em uma frase
O llms.txt é um resumo do site escrito em Markdown, publicado num endereço fixo, que dá a uma IA o contexto mínimo e o mapa das páginas principais, com links para versões limpas do conteúdo.
Quem criou e por quê
A proposta foi publicada em 3 de setembro de 2024 por Jeremy Howard, cofundador da Answer.AI, no site llmstxt.org. A justificativa está no próprio texto: as janelas de contexto dos modelos, mesmo maiores que antes, ainda são pequenas demais para a maioria dos sites inteiros, e cada palavra desperdiçada custa tempo e dinheiro. O HTML embrulha a informação em navegação, anúncios e JavaScript, e converter isso de volta em texto limpo é difícil e impreciso.
A ideia pegou primeiro em sites de documentação técnica. Em consulta que fizemos em 17 de outubro de 2026, os arquivos de documentação da Anthropic, da OpenAI, da API do Gemini e do Perplexity respondiam normalmente. Note que são sites para programadores, onde o arquivo ajuda assistentes de código a achar a documentação certa. O site llmstxt.org ganhou uma versão 2 da especificação em agosto de 2026.
O formato oficial do llms.txt
A especificação pede uma ordem fixa. Só o primeiro item é obrigatório.
- Um título H1 com o nome do projeto ou do site.
- Um bloco de citação (a linha começa com
>) com um resumo curto e as informações principais. - Zero ou mais parágrafos ou listas com detalhes, sem títulos.
- Zero ou mais seções com título H2, cada uma com uma lista de arquivos. Cada item da lista é um link em Markdown,
[nome](url), seguido opcionalmente de dois-pontos e uma nota. - Uma seção chamada "Optional", por convenção, para links secundários que a IA pode pular quando precisar economizar contexto.
A especificação também sugere oferecer versões em Markdown das páginas importantes no mesmo endereço, com .md no fim (por exemplo, pagina.html.md). E diz que o arquivo pode ficar na raiz (/llms.txt) ou em um subcaminho, como /docs/llms.txt, valendo para as páginas abaixo dele.
Um esqueleto mínimo fica assim:
# Nome da Empresa

> Uma ou duas frases dizendo o que a empresa faz, para quem e onde atende.

Informações que ajudam a IA a responder perguntas comuns: horário,
área de atendimento, o que a empresa não faz.

## Serviços

- [Serviço A](https://seusite.com.br/servico-a/): o que é e para quem serve
- [Serviço B](https://seusite.com.br/servico-b/): o que é e para quem serve

## Perguntas frequentes

- [Quanto custa](https://seusite.com.br/quanto-custa/): faixas de preço e o que muda o valor

## Optional

- [Blog](https://seusite.com.br/blog/): artigos de apoio
llms.txt e llms-full.txt: qual a diferença
O nome llms-full.txt aparece muito em plugins e em sites de documentação. É uma convenção do mercado, não descrita na especificação do llmstxt.org: em vez de listar links, o arquivo traz o conteúdo inteiro das páginas principais num texto só, para quem quer carregar tudo de uma vez. Faz sentido em documentação técnica, onde um programador cola o arquivo inteiro no assistente. Para o site de uma clínica ou de uma agência, um llms.txt bem feito costuma bastar.
O que o Google diz sobre llms.txt
Aqui é preciso ser direto. O Google afirma no seu guia de otimização para IA, atualizado em julho de 2026, que não é preciso criar arquivos legíveis por máquina, arquivos de texto para IA, marcação ou Markdown para aparecer na Busca. Na prática, a Busca do Google ignora o arquivo, tanto no ranqueamento quanto na Visão geral criada por IA e no Modo IA.
Ao mesmo tempo, outra área do próprio Google passou a olhar o arquivo. O Lighthouse, ferramenta de auditoria do Chrome, ganhou em 2026 uma categoria de "navegação por agentes", e a documentação do Chrome, de maio de 2026, descreve o llms.txt como uma convenção emergente para dar um resumo do site a LLMs e agentes de IA. A auditoria só aponta problema se o servidor der erro ao entregar o arquivo. Se o arquivo não existir (erro 404), o item fica como "não aplicável", porque ainda é opcional. O texto do Chrome diz que, sem o arquivo, agentes podem gastar mais tempo rastreando o site para entender a estrutura.
Resumindo: para a Busca do Google, irrelevante. Para agentes que navegam e executam tarefas, um sinal útil e barato.
Alguém lê o llms.txt? O que diz o estudo da Ahrefs
A Ahrefs publicou em junho de 2026 um estudo com 137 mil domínios que usam a ferramenta de análise dela. Os números são duros: 28% desses domínios tinham llms.txt, e 97% desses arquivos não receberam nenhuma visita, de robô ou de gente, em maio de 2026. Nos 3% que receberam alguma, 96% das requisições vieram de robôs. Entre as ferramentas de IA identificadas, o GPTBot, da OpenAI, foi o que mais buscou os arquivos, seguido do Claude Code, o assistente de programação da Anthropic.
A leitura honesta: hoje o llms.txt é mais usado por assistentes de programação e por robôs de coleta do que por buscadores de IA. Ele não vai, sozinho, colocar a sua empresa no ChatGPT. Por que fazer, então? Porque custa uma hora, não tem efeito negativo conhecido, ajuda agentes que já leem o arquivo e obriga a empresa a escrever, num lugar só, a descrição oficial dela. Esse último ponto é o que mais vale, como mostramos em o que é LLMO.
O exemplo real: o llms.txt da IKOEH
A ikoeh.com tem um llms.txt no ar desde antes deste artigo, e você pode abrir em ikoeh.com/llms.txt. Vamos usar o nosso próprio arquivo como exemplo, com o que estava certo e com o que estava errado e foi corrigido.
O começo segue a especificação:
# IKOEH

> Agência de marketing digital em Osasco, SP. Atende empresas e clínicas de São Paulo, Paraná, Minas Gerais e Rio de Janeiro. Sede física em Osasco/SP com atendimento presencial para a Grande São Paulo. Não atende Norte, Nordeste, Centro-Oeste nem Sul (exceto Paraná).
O que está certo aqui: o H1 com o nome, o resumo em bloco de citação, e uma informação que quase ninguém coloca e que evita erro de IA: onde a empresa não atende. Quando alguém de Fortaleza pergunta a uma IA por uma agência, é melhor que ela saiba que a IKOEH não é opção.
Logo depois vêm seções como "Identidade e contato", "Diferenciais" e "Perguntas e respostas frequentes", com fatos objetivos: ano de fundação (2005), tamanho da equipe (5 profissionais), horário, telefone, prazos típicos ("um site institucional leva de 2 a 4 semanas"). É o tipo de dado que uma IA consegue repetir sem inventar.
Quando começamos este artigo, o arquivo tinha quatro defeitos. Todos foram corrigidos em 17 de outubro de 2026, e vale contar o que era cada um, porque são os erros mais comuns que encontramos em outros sites:
Os links não seguiam o formato da especificação. As linhas estavam como - Criação de Sites: https://ikoeh.com/criacao-de-sites/ seguido de descrição. Agora estão no formato oficial, - [Criação de Sites](https://ikoeh.com/criacao-de-sites/): descrição, que qualquer leitor que segue a especificação reconhece como lista de links.
Não existia seção "Optional". As dezenas de links de blog, com tráfego pago por cidade e versões em inglês, ficavam no meio do arquivo. Agora estão no fim, numa seção Optional, para que um agente com pouco contexto leia primeiro os serviços, as perguntas frequentes e as regiões.
O arquivo era entregue sem charset. O servidor respondia content-type: text/plain sem indicar UTF-8, e alguns leitores podiam exibir os acentos quebrados. Agora o llms.txt e o llms-full.txt saem como text/plain; charset=utf-8.
O nome da marca variava. O llms.txt dizia "IKOEH" e "IKOEH Creations", e o llms-full.txt usava "ikoeh" em minúsculas. Agora os dois arquivos usam "IKOEH", igual ao resto do site e aos dados estruturados. Para uma máquina que tenta ligar fatos a uma entidade, consistência de nome ajuda.
Mostrar isso aqui é proposital. Um llms.txt é um documento vivo, e quase todo site que tem um carrega pelo menos um desses problemas.
Como fazer o seu llms.txt, passo a passo
1. Escreva a descrição oficial da empresa. Duas ou três frases: o que faz, para quem, onde atende e onde não atende. Use as mesmas palavras do Perfil da Empresa no Google e da página "Sobre". Essa frase vai virar o bloco de citação.
2. Liste os fatos que um cliente pergunta. Horário, endereço, telefone, formas de pagamento, convênios, prazos, faixas de preço quando você as divulga. Só fatos verdadeiros e atuais.
3. Escolha de 10 a 30 páginas principais. Serviços, páginas de preço, perguntas frequentes, contato, e os artigos que mais respondem dúvidas. Para cada uma, escreva uma nota de uma linha dizendo o que a página responde.
4. Monte o arquivo no formato oficial. H1, bloco de citação, parágrafos de detalhe, seções H2 com links em Markdown e, no fim, a seção Optional com o que é secundário.
5. Publique na raiz do site. Em WordPress, há plugins que geram e servem o arquivo, e a própria especificação cita integrações com plataformas como WordPress, Mintlify e GitBook. Em sites estáticos (Astro, Next.js, HTML puro), basta colocar o arquivo llms.txt na pasta pública. Confira se o endereço responde com código 200 e com UTF-8.
6. Teste. Abra o endereço no navegador e veja se os acentos aparecem certos. Rode o Lighthouse do Chrome e confira a categoria de navegação por agentes. Peça a um assistente de IA com acesso à web para ler o arquivo e resumir a sua empresa, e veja se ele entende.
7. Atualize junto com o site. Página nova importante, serviço que saiu, telefone que mudou: atualize o llms.txt no mesmo dia. Um arquivo desatualizado ensina informação errada.
Modelo de llms.txt para uma clínica
Abaixo, um modelo com dados fictícios marcados entre colchetes. Substitua tudo pelos dados reais do seu negócio.
# [Nome da Clínica]

> Clínica de [especialidade] em [bairro], [cidade], SP. Atende particular e
> os convênios [lista]. Responsável técnico: [nome], [registro no conselho].

Horário: segunda a sexta, [horário]. Sábado, [horário].
Endereço: [rua, número, bairro, cidade, CEP].
Agendamento: [telefone e link de WhatsApp].
Não realizamos: [procedimentos que a clínica não faz].

## Tratamentos

- [Tratamento A](https://[site]/tratamento-a/): para quem é indicado e como funciona
- [Tratamento B](https://[site]/tratamento-b/): para quem é indicado e como funciona

## Antes de agendar

- [Convênios aceitos](https://[site]/convenios/): lista atualizada
- [Primeira consulta](https://[site]/primeira-consulta/): o que levar e quanto dura

## Optional

- [Blog](https://[site]/blog/): artigos sobre saúde escritos pela equipe
Para clínicas e consultórios, lembre que o texto precisa seguir as regras do conselho profissional (CFM, CFO e outros), assim como o resto do site.
Erros comuns ao criar llms.txt
Copiar o site inteiro para dentro do arquivo. O objetivo é resumir. Para conteúdo completo, existe o llms-full.txt ou as versões .md das páginas.
Escrever propaganda. "A melhor clínica da cidade" não é fato verificável e não ajuda a IA a responder nada.
Esquecer de atualizar. O arquivo envelhece em silêncio porque ninguém o vê.
Achar que ele substitui o resto. Sem robôs liberados no robots.txt, páginas indexadas e reputação fora do site, o llms.txt não faz milagre. O caminho completo está em o que é GEO, em como as IAs escolhem quem citar e em como aparecer no ChatGPT.
Quer um llms.txt bem feito, e o resto também?
A IKOEH cria e mantém o llms.txt como parte de um trabalho completo de SEO para IAs, junto com robots.txt, dados estruturados, conteúdo em formato de resposta e reputação fora do site. Atendemos empresas e clínicas de São Paulo, Paraná, Minas Gerais e Rio de Janeiro.
Veja o serviço de SEO para IAs, conheça a nossa agência de GEO ou chame no WhatsApp para revisarmos o arquivo do seu site.
Perguntas frequentes sobre llms.txt
O que é llms.txt?
É um arquivo em Markdown publicado na raiz do site, em /llms.txt, que resume a empresa ou o projeto e lista as páginas principais com links e descrições, para que modelos de linguagem e agentes de IA entendam o site com menos esforço.
Quem criou o llms.txt?
Jeremy Howard, cofundador da Answer.AI, publicou a proposta em 3 de setembro de 2024 no site llmstxt.org. A especificação ganhou uma versão 2 em agosto de 2026.
O llms.txt melhora o SEO no Google?
Não. O Google afirma no guia de otimização para IA que não é preciso criar arquivos de texto para IA para aparecer na Busca. Na prática, a Busca ignora o arquivo.
O ChatGPT lê o llms.txt?
Um estudo da Ahrefs de junho de 2026 mostrou que o GPTBot, robô de coleta da OpenAI, foi o agente de IA identificado que mais buscou esses arquivos. A OpenAI não declara usar o llms.txt para escolher fontes nas respostas do ChatGPT.
Qual a diferença entre llms.txt e robots.txt?
O robots.txt diz aos robôs o que eles podem ou não acessar. O llms.txt não dá permissão nem bloqueia nada: ele apenas resume o site e aponta as páginas principais. Os dois podem e devem coexistir.
Qual a diferença entre llms.txt e llms-full.txt?
O llms.txt é um índice com resumo e links. O llms-full.txt, convenção adotada por plugins e sites de documentação, traz o conteúdo completo das páginas num arquivo só.
Pequena empresa precisa ter llms.txt?
Não é obrigatório. Como custa pouco e obriga a empresa a escrever uma descrição oficial e coerente, recomendamos fazer, desde que o básico de SEO e de presença local já esteja em ordem.
Onde colocar o llms.txt no WordPress?
Na raiz do domínio, acessível em seusite.com.br/llms.txt. Dá para enviar o arquivo por FTP ou gerenciador de arquivos da hospedagem, ou usar um plugin que gere e sirva o arquivo automaticamente.